O fim da tela de carregamento: 100 mil linhas com Server-Sent Events
Relatórios grandes não precisam travar a tela. Como o SorlaDB entrega os dados em blocos para as pessoas começarem a trabalhar no primeiro segundo, sem nenhuma infraestrutura nova.

Segunda-feira, 9h02. Uma diretora de operações abre o relatório de pedidos para decidir quais entregas precisam de atenção na semana. A tela fica branca. Aparece o ícone de carregando. Dez segundos. Vinte. Aos quarenta, o navegador pergunta se ela quer interromper a página.
Ela não espera. Liga para um analista e pede "aquela planilha da semana passada". A decisão é tomada com dados velhos, e ninguém abre um chamado, porque "o relatório é lento mesmo".
Quase toda empresa tem uma tela assim. Ninguém planejou: os dados só cresceram mais rápido do que a forma como a gente carrega esses dados. Este post é sobre resolver isso sem plataforma nova, sem fornecedor novo e sem reescrever o sistema.
Por que telas grandes travam
O jeito comum de carregar um relatório é uma requisição e uma resposta gigante: o servidor junta todas as linhas, transforma tudo em um único JSON enorme e envia. O navegador não consegue mostrar nada até chegar o último byte, depois processa tudo de uma vez, e é aí que a página congela.
Três coisas dão errado nesse modelo:
- Nada é útil até tudo chegar. A linha 1 espera a linha 100.000.
- Processar uma resposta gigante trava a tela. Rolar e clicar param enquanto o navegador digere tudo.
- Uma conexão que cai obriga a começar de novo. No trem, no Wi-Fi do hotel ou numa VPN cheia, um download de 40 segundos é cara ou coroa.
A ideia: entregar em caixas, não num caminhão só
Quando você muda um galpão de lugar, não espera um caminhão gigante ficar totalmente carregado para algo sair. Você manda caixas. As primeiras chegam enquanto o resto ainda está sendo embalado, e se uma caixa se perde, você reenvia aquela caixa, não o galpão inteiro.
Server-Sent Events (SSE) é essa ideia, já embutida em todo navegador. O servidor mantém uma resposta HTTP comum aberta e escreve os dados em blocos, por exemplo de 5.000 linhas. O SorlaDB recebe cada bloco e adiciona a uma coleção que a interface já consegue consultar.
O que muda para o negócio
- As pessoas começam a trabalhar no primeiro segundo. O primeiro bloco aparece quase na hora, e o resto continua chegando enquanto elas rolam, buscam e filtram.
- Progresso visível no lugar da incerteza. "Carregando 20.000 de 100.000 linhas…" é uma promessa cumprida. Um ícone girando é uma pergunta que ninguém sabe responder.
- Rede ruim deixa de custar trabalho. Se a conexão cai, o navegador reconecta e o servidor continua do último bloco que entregou.
- Nenhuma infraestrutura nova. SSE é HTTP comum. Passa pelos proxies, balanceadores, autenticação e monitoramento que você já tem. Não há broker de mensagens para comprar nem protocolo novo para a segurança aprovar.
Como funciona
O protocolo tem poucos eventos com nome. O servidor informa o total, envia as linhas em blocos numerados e avisa quando terminou:
event: meta
data: {"total": 100000}

id: 1
event: rows
data: [{"_id": 1, "customer": "ACME", "status": "late"}, … 5000 linhas …]

id: 2
event: rows
data: [ … ]

event: end
data: {}
No navegador, uma chamada inicia o fluxo e mantém a coleção atualizada:
const app = new sorla();
app.useDb('reports');
app.db.createCollection('orders');

const loading = app.db.orders.stream('/api/orders/stream', {
  headers: { Authorization: `Bearer ${token}` },
  onProgress: ({ loaded, total }) => (bar.value = total ? loaded / total : 0)
});

// A interface já pode consultar enquanto os dados chegam
app.db.orders.find({ status: 'late' }).sort({ due: 1 }).limit(50).toArray();

const state = await loading.done; // { loaded, total, blocks, errors, … }
Cada bloco é gravado com um único bulkWrite. As linhas são casadas pelo _id, então um bloco recebido duas vezes depois de uma reconexão atualiza as linhas em vez de duplicar.
No servidor, os detalhes importantes são enviar o número do bloco como id do evento e desacelerar quando o navegador lê mais devagar do que o servidor escreve:
import http from 'node:http';

http.createServer(async (req, res) => {
  if (req.url !== '/api/orders/stream') return res.end();
  res.writeHead(200, { 'Content-Type': 'text/event-stream', 'Cache-Control': 'no-cache' });

  const orders = await loadOrders();                      // a sua fonte de dados
  const size = 5000;
  const resumeAt = Number(req.headers['last-event-id'] ?? 0); // blocos que o navegador já tem

  res.write(`event: meta\ndata: ${JSON.stringify({ total: orders.length })}\n\n`);
  for (let block = resumeAt; block * size < orders.length; block++) {
    const rows = orders.slice(block * size, (block + 1) * size);
    const ok = res.write(`id: ${block + 1}\nevent: rows\ndata: ${JSON.stringify(rows)}\n\n`);
    if (!ok) await new Promise((resolve) => res.once('drain', resolve)); // o navegador está mais lento: espere
  }
  res.end('event: end\ndata: {}\n\n');
}).listen(3000);
Quando a conexão cai, o navegador reconecta e envia o Last-Event-ID. O servidor pula os blocos que já chegaram, e ninguém baixa nada duas vezes.
Num produto de verdade: Intelligent Grid
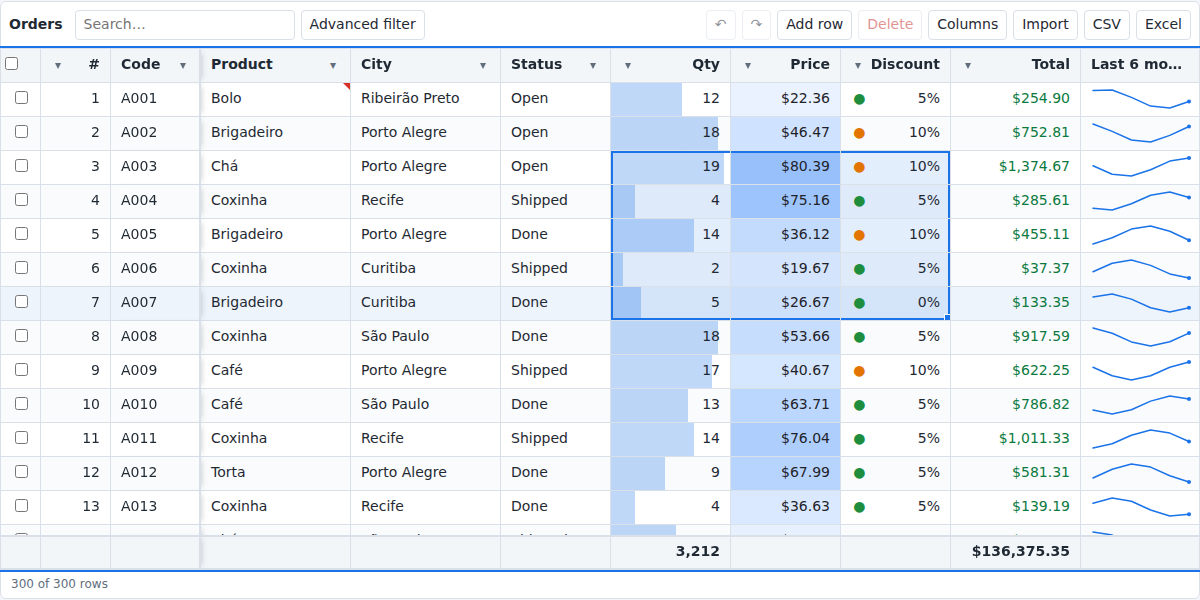
O Intelligent Grid, o nosso grid de dados no estilo Excel feito sobre o SorlaDB, usa exatamente isso para carregar bases grandes. Uma linha inicia a carga:
const stream = grid.loadStream('/api/orders/stream', { onProgress: updateBar });
As linhas aparecem conforme cada bloco chega, a barra de status mostra "Carregando 20.000 de 100.000 linhas…", e a pessoa pode ordenar e filtrar durante a carga. Como só as linhas visíveis são desenhadas, 100.000 linhas rolam a 60 quadros por segundo estáveis nos nossos benchmarks.
Quando usar, e quando não usar
- Poucos dados: um
fetchsimples continua sendo a resposta mais fácil. SSE é uma alternativa, não um substituto. - Relatórios grandes, exportações e dashboards: é aqui que o SSE brilha. Dezenas ou centenas de milhares de linhas, com progresso e retomada.
- Dados que mudam enquanto as pessoas olham, ou rolagem infinita sob demanda: isso é trabalho para um WebSocket, o assunto do nosso próximo post.
A conclusão para quem lidera
O relatório lento raramente é um problema de hardware. É um problema de entrega: mandamos tudo de uma vez e fazemos as pessoas esperarem a última linha. Enviar os dados em blocos transforma uma espera de 40 segundos num começo no primeiro segundo, continua funcionando em redes ruins e roda na infraestrutura HTTP que você já paga.
Se a sua equipe tem uma tela que as pessoas evitam porque é lenta, essa tela é um ótimo lugar para começar. O guia de sincronização com o servidor tem tudo de que os desenvolvedores precisam, e o SorlaDB é open source no GitHub.